ChatGPTを使って文章を作ったことはあっても、「LLMでは、ほかに何ができるのだろう」「自分の仕事にも使えるのだろうか」と感じている方もいるかもしれません。
LLM(大規模言語モデル)とは、大量の文章データをもとに言葉の関係やパターンを学習し、入力された内容に応じて文章の生成や処理を行う技術です。
LLMでできることは、文章作成だけではありません。
長い文章を要約する、内容を分類する、必要な情報を取り出す、複数の案を比較する、コードを作るなど、言葉や情報に関わるさまざまな処理に利用できます。
ただ、活用例を一つずつ見ていると、それぞれ別の使い方に見えて、自分の仕事へどう当てはめればよいのか分かりにくいことがあります。
この記事では、LLMでできることを「生成する」「要約する」「分類する」といった処理能力ごとに紹介します。
さらに、仕事での使われ方や、LLM単体とChatGPTなどのAIサービスの違い、実務で使う前に確認したい点も取り上げます。
個々の活用例を覚えるのではなく、「自分の作業のどこをLLMに任せられそうか」という視点で捉えてみてください。
音声でも聴けます
この記事の内容を、音声で聴きやすい形に再構成しています。 LLMでできることを、文章生成だけでなく、要約・分類・情報抽出・分析・コード生成など、 仕事で任せられる処理の違いから、移動中や作業中にも聴いていただけます。
音声のみで聴く: Spotify | Apple Podcasts | Amazon Music
【1】LLMでできることは文章生成だけではない
LLMというと、ChatGPTのように質問へ答えたり、文章を書いたりする機能を思い浮かべる人が多いかもしれません。
ただ、文章生成はLLMができることの一部です。
要約や分類、情報抽出など、すでにある文章を読み取り、目的に合わせて処理する使い方もあります。
LLMは言葉を生成・処理する大規模言語モデル
LLMは、入力された文章や指示をもとに、言葉を生成したり、文章の内容を処理したりする大規模言語モデルです。
新しい文章を作るだけでなく、長い文章を短くまとめる、内容ごとに分ける、必要な情報だけを抜き出すといった処理にも使われます。
そのため、「文章を書くための技術」とだけ捉える思っていると、LLMでできることの一部しか見えません。
言葉や情報をさまざまな形で扱える技術として考えるほうが、実際の用途に近いでしょう。
【関連記事|A02】LLMとは?GPTの仕組み・学習データ・使い方までを一気に理解する
LLMでできることは「処理能力」で整理するとわかりやすい
LLMの活用例としては、メール作成、議事録の要約、問い合わせの振り分けなどが挙げられます。
用途だけを見ると、それぞれ別の機能のようにも見えます。
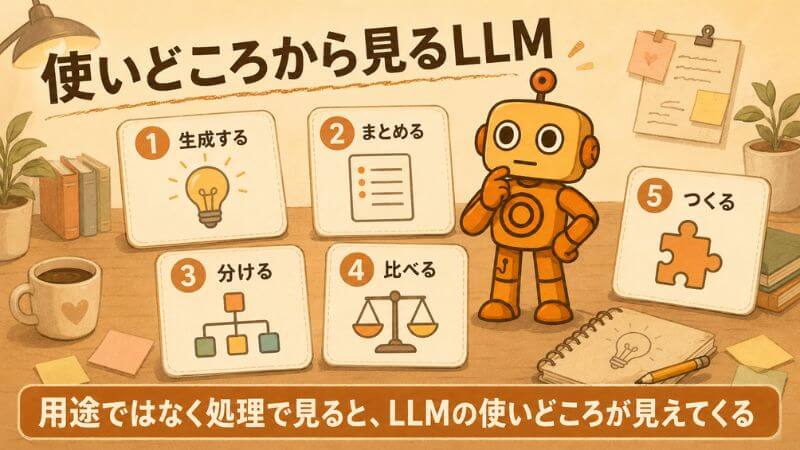
そこで、「何に使っているか」ではなく、「LLMに何をさせているか」に置き換えてみます。
メール作成なら「生成」、議事録なら「要約」、問い合わせの振り分けなら「分類」といった具合です。
こうして処理ごとに見ると、自分の仕事の中に似た作業がないか探しやすくなります。
LLMの同じ能力をさまざまな用途に応用できる
一つの処理能力は、一つの用途だけに対応しているわけではありません。
たとえば「要約」は、会議録を短くまとめるときにも、長い資料から要点をつかむときにも使われます。
扱う文章や目的は違っても、LLMに任せている処理そのものは共通しています。
活用例をそのまま覚えるより、「この仕事では、どの処理をしているのか」と見るほうが、別の作業にも当てはめやすくなります。
【2】LLMでできる主なこと|生成・要約・分類・推論まで
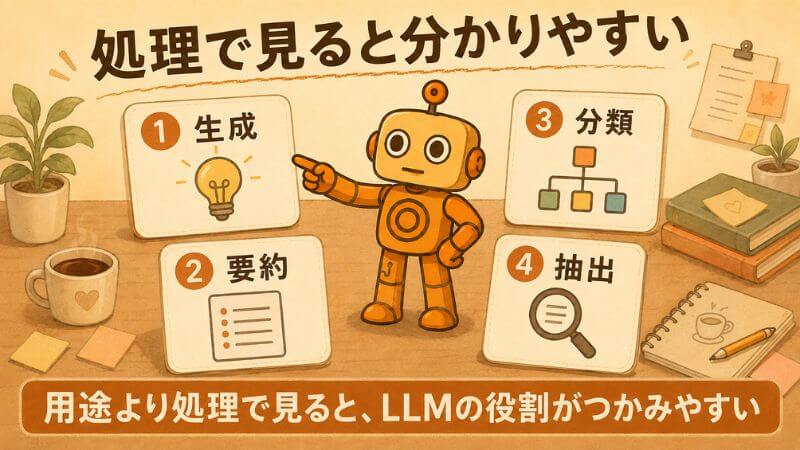
LLMは文章を作るだけでなく、すでにある情報を短くしたり、分類したり、必要な部分を取り出したりできます。
代表的な処理を分けると、次のようになります。
| 処理能力 | 何ができるか | 主な用途 |
|---|---|---|
| 文章生成 | 条件や文脈に沿った文章を作る | メール、説明文、企画案 |
| 要約・翻訳・言い換え | 元の情報を別の長さや表現へ変える | 資料整理、翻訳、文章調整 |
| 分類・情報抽出 | 内容を分けたり、必要な情報を取り出したりする | 問い合わせ整理、項目抽出 |
| 質問応答・分析・推論 | 情報をもとに回答や比較材料を出す | 資料の確認、比較、検討 |
| コード生成 | コードの作成や説明、修正案の提示を行う | 開発、学習、修正案の作成 |
文章生成では条件や文脈に合わせて文章を作れる
箇条書きのメモからメールの下書きを作る、といった使い方が文章生成です。
テーマだけを渡して説明文を作らせたり、条件を指定して複数の案を出してもらったりすることもできます。
相手や目的、文章の長さを伝えれば、それに合わせて表現を変えることも可能です。
【関連記事|B01】プロンプトの作り方|思考の型・設計手順・使い回し方までを総まとめ
要約・翻訳・言い換えでは情報の形を変えられる
要約や翻訳では、ゼロから内容を作るわけではありません。
長い資料を短くする、別の言語へ置き換える、専門的な説明をやさしい表現に直すなど、すでにある情報の伝え方を変える処理です。
元の内容を保ちながら、読み手や用途に合う形へ変えたいときに使われます。
分類・情報抽出では必要な情報を整理して取り出せる
文章が大量にあるときは、「どの種類に分けるか」「何を抜き出すか」を指定して処理できます。
たとえば問い合わせを内容ごとに振り分けるのが分類、文章から氏名や日付、要望だけを取り出すのが情報抽出です。
全文を読み直さなくても、必要な項目に沿って情報を集める用途に向いています。
※情報抽出:文章の中から、指定した条件に当てはまる情報を取り出す処理です。
質問応答・分析・推論では情報整理や検討を支援できる
資料を渡して内容について質問したり、複数案の違いを条件ごとに比較したりする使い方もあります。
与えた情報から共通点や相違点を挙げる、不足している情報を洗い出すなど、検討前の材料をそろえる処理にも使えます。
ただし、LLMが出した結論そのものが正しいとは限らないため、判断に使う場合は元の情報も確認する必要があります。
※推論:与えられた情報や条件の関係をもとに、回答や結論の候補を導く処理です。
コード生成では作成・説明・修正を支援できる
LLMが扱えるのは自然言語だけではありません。
「この処理をするコードを作ってほしい」と文章で指示してコードを生成したり、既存コードの意味を説明させたりできます。
エラーの内容を渡して修正案を出してもらう使い方もあり、開発だけでなくプログラミング学習にも利用されています。
【3】LLMは仕事でどう使える?処理能力から活用法を考える
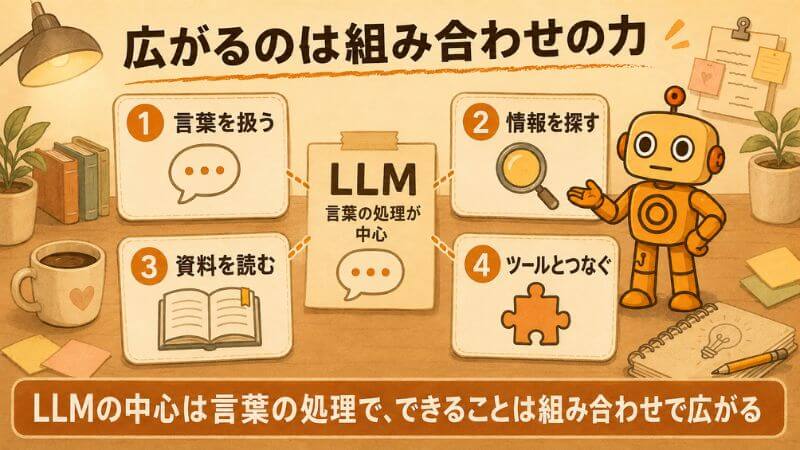
LLMの処理能力がわかっても、それだけでは「自分の仕事のどこで使えるのか」まではあまり見えてこないのではと思います。
実際の仕事では、一つの業務の中で生成、要約、分類などを組み合わせて使うことがあります。
文章作成、情報整理、調査や検討を例に、仕事のどこで使うのかを見てみます。
文章作成では生成と言い換えを組み合わせる
文章作成では、最初から完成文を作らせるだけが使い方ではありません。
たとえば、伝えたい内容を箇条書きで渡してメールの下書きを作り、そのあとで「もう少し簡潔にする」「やわらかい表現にする」と言い換えを依頼できます。
企画書や説明文でも、内容を文章にする工程と、すでにある文章を読みやすく直す工程では、使っている処理が異なります。
一つの文章でも、生成と言い換えを分けて使う方法があります。
情報整理では要約・分類・情報抽出を使い分ける
資料や問い合わせを扱うときは、何を知りたいかによって使う処理が変わります。
全体を短時間で把握したいなら要約、内容ごとに分けたいなら分類、日付や要望など決まった項目だけが欲しいなら情報抽出です。
たとえば同じ資料でも、「まず概要を読みたい」ときと「必要な項目だけ一覧にしたい」ときでは、LLMへの頼み方は同じではありません。
先に欲しい結果を決めると、使う処理も選びやすくなります。
調査や検討では質問応答・分析・推論を補助に使う
調査や検討では、集めた情報を読み比べる作業の補助にLLMを使えます。
複数案の違いを条件ごとに並べる、資料に含まれる論点を挙げる、与えた前提から追加で確認したい項目を出す、といった使い方です。
自分で結論を出す前に、比較する材料や確認項目を並べてもらう用途にも向いています。
LLMに判断を任せるというより、検討の前段階で情報を扱いやすい形にする使い方です。
企業の導入事例からLLMが業務のどこで使われているかを見る
日本企業でも、LLMは一つの用途に限らず、調査や分析、コード作成などに使われています。
ENEOSマテリアルでは、ChatGPT Enterpriseを研究開発、生産技術、人事などの業務に導入しています。
プロセス開発部では、技術調査にdeep researchを活用し、案件によって数か月かかっていた調査を数十分まで短縮しました。
人事部では、研修結果の分析にも利用しています。
手作業では1〜2時間かかっていた分析が20秒で完了し、ChatGPTを使って作成した集計ツールでは、作業時間を約90%削減したと報告されています。
この事例を見ると、調査では情報収集や分析、人事業務ではデータ処理やコード生成というように、一つの企業でも業務に応じて異なる処理能力が使われていることがわかります。
【関連記事|C01】生成AIの使い方|文章作成・会議・自動化まで“仕事で使いこなす”実践ガイド
出典:OpenAI「ENEOSマテリアル、ChatGPT Enterprise で製造業に新たな働き方を」
【4】LLM単体の能力とChatGPTなどの機能は同じではない
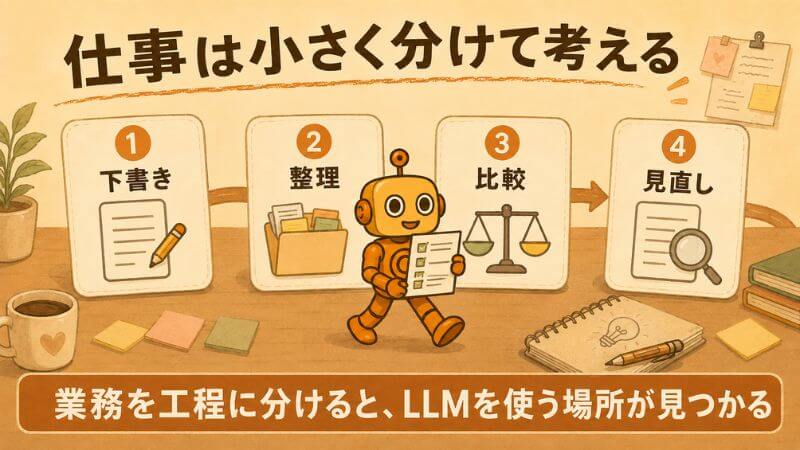
ChatGPTなどでWeb検索やファイルの読み取りができると、それらもLLMそのものの能力のように見えやすくなります。
ただし、LLMが担う言語処理と、検索や外部機能によって実現している処理は別のものです。
サービスとして何ができるのかを見るときは、LLM単体の能力と、その周囲に加えられた機能を分けて認識しておく必要があります。
LLM単体の中心は言語情報の生成と処理
LLM単体が得意とするのは、入力された言葉や情報をもとに文章を生成したり、内容を処理したりすることです。
文章生成、要約、分類、質問応答などが代表的な例です。
一方、Web上から最新情報を取得したり、社内データベースへ接続したりするには、LLMとは別の仕組みが必要になります。
そのため、「ChatGPTでできること」が、そのまま「LLM単体でできること」とは限りません。
RAGは外部情報を参照させ、ファインチューニングは特定用途へ調整する
LLMをそのまま使うだけでは足りないときに、RAGやファインチューニングが使われることがあります。
RAGは、必要な外部情報を取得し、その内容を回答の材料としてLLMへ渡す仕組みです。
たとえば、社内資料や最新の情報を参照しながら回答させたい場合に使われます。
ファインチューニングは、追加の学習データを使い、特定の用途に合った出力をしやすいようモデルを調整する方法です。
RAGは主に「回答時に参照する情報」を補い、ファインチューニングは「モデルの出力傾向」を調整する、と考えると違いをつかみやすくなります。
※RAG:外部から必要な情報を取得し、その情報をLLMの回答生成に利用する仕組み。
※ファインチューニング:学習済みモデルを追加のデータで学習させ、特定の用途に合わせて調整する方法。
ChatGPTなどはLLMに検索や外部ツールを組み合わせている
ChatGPTなどのAIサービスでは、LLMだけで処理を完結させているわけではありません。
Web検索やファイル処理などを組み合わせることで、最新情報を調べたり、アップロードした資料を読んだりできるようになっています。
利用者から見ると一つのサービスですが、その中ではLLMと周辺機能が役割を分けています。
「どのLLMを使っているか」だけでなく、検索やファイル処理など、どの機能が組み合わされているかによって対応できる作業も変わります。
【関連記事|C02】ChatGPTの使い方|文章生成・分析・企画まで“仕事で使う”ための完全ガイド
【深掘り記事|A02-04】主要LLMの比較|GPT・Claude・Geminiの特徴と違いを整理する
画像や音声を扱う機能はマルチモーダルAIとして広がっている
AIサービスの中には、文章だけでなく画像や音声を扱えるものもあります。
画像の内容について質問したり、音声でやり取りしたりする機能は、テキストだけを扱うLLMの説明だけでは捉えきれません。
テキスト、画像、音声など、複数の種類の情報を扱える仕組みはマルチモーダルAIと呼ばれます。
※マルチモーダルAI:テキスト、画像、音声など、複数の種類の情報を扱えるAIです。
AIエージェントはLLMと外部ツールを組み合わせて処理を進める
AIエージェントでは、LLMが回答文を作るだけでなく、必要に応じて検索やファイル操作などの外部ツールを使いながら処理を進めます。
たとえば、情報を探して、その結果を読み取り、次に必要な操作を選ぶといった流れです。
ここでも、すべてをLLM単体が行っているわけではありません。
LLMが言語処理や判断の一部を担い、外部ツールが検索や操作を受け持つことで、文章生成だけでは対応しにくい作業まで扱えるようになります。
※AIエージェント:LLMなどのモデルと外部ツールを組み合わせ、目的に応じて複数の処理を進める仕組みです。
【5】LLMでできることと実務で安全に使えることは分けて考える
LLMが文章を作ったり、情報を分析したりできても、その結果をそのまま仕事で使ってよいとは限りません。
実務では、出力内容の正確さに加えて、入力する情報や生成物の扱いも確認する必要があります。
リスクによって、確認するタイミングや対象は異なります。
ハルシネーションがあるため自然な回答でも事実確認が必要になる
LLMの回答は、自然に読めるからといって事実まで正しいとは限りません。
OpenAIも、言語モデルがもっともらしいものの正しくない内容を生成する「ハルシネーション」が起こり得ると説明しています。
特に、日付、金額、固有名詞、出典などは、正誤を確かめやすい一方で、誤りを見落とすと判断に影響します。
文章の読みやすさと事実の正しさは分けて考え、必要な箇所は元資料や一次情報に戻って確認します。
※ハルシネーション:LLMが、もっともらしく見えるものの事実とは異なる内容を生成する現象です。
LLMの分析・推論は人間の判断と同じものではない
LLMは、複数の情報を比較したり、選択肢や論点を並べたりする処理にも使えます。
ただし、そこで示された結論が、そのまま正しい判断になるわけではありません。
NISTも、生成AIには不正確な情報など複数のリスクがあり、利用目的や影響に応じた管理が必要だとしています。
比較結果や候補は検討材料として使い、最終判断に関わる事実や条件は別に確かめる、という分け方が現実的です。
機密情報や個人情報を扱うときは情報漏洩リスクを確認する
個人情報や社外秘の資料は、回答が生成されたあとではなく、LLMへ入力する段階で注意が必要です。
顧客や従業員の個人情報、機密資料、契約上取り扱いが制限されている情報などは、サービスへ入力してよいかを先に確かめます。
個人情報保護委員会も、生成AIサービスへ個人データを入力する場合には、利用目的やサービス提供者によるデータの取り扱いを確認するよう注意を促しています。
業務で使うなら、まず利用中のサービスの条件と社内ルールを確認することになります。
生成物を利用するときは著作権や利用条件を確認する
生成物については、入力時ではなく、公開や販売などで利用する段階にも確認事項があります。
文化庁は、AI生成物であっても、既存の著作物との類似性や依拠性などによって著作権侵害となる可能性があると整理しています。
さらに、AIサービスごとに生成物の利用条件が定められている場合もあります。
文章や画像を生成できたことと、外部公開や商用利用が問題なくできることは同じではありません。
利用方法を決める段階で、既存の著作物との関係とサービスの条件を確認します。
【深掘り記事|A01-04】生成AIの注意点|誤情報・著作権・プライバシーをどう扱うか?
【6】LLMに任せる仕事は3つの判断軸で考える
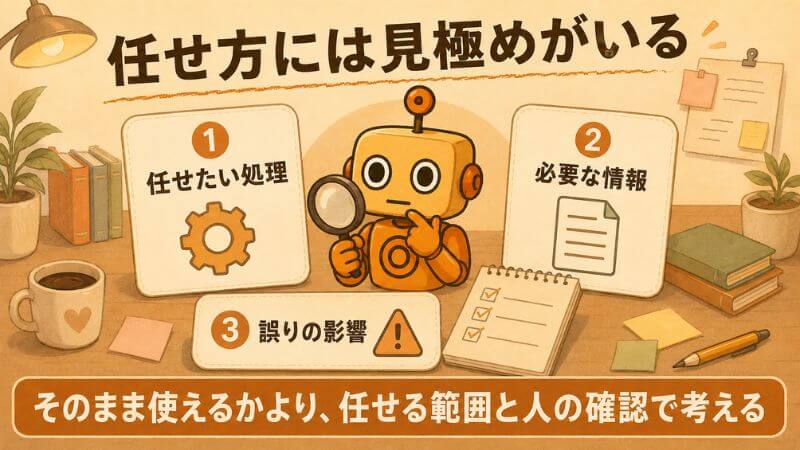
LLMを仕事で使うときは、「この業務を全部任せられるか」で考える必要はありません。
見るのは、任せたい処理、必要な情報、間違った場合の影響の3つです。
この3点に分けると、LLMを使う部分と人が受け持つ部分を切り分けられます。
仕事全体ではなくLLMに任せる処理へ分けて考える
まず、仕事をいくつかの処理に分けます。
たとえば企画書の作成には、情報収集、構成づくり、文章生成、事実確認などが含まれます。
このうち文章のたたき台はLLMに任せ、数字や事実は人が確認する、といった分け方ができます。
企画書を丸ごと任せる必要はなく、使える処理だけを切り出せば十分です。
手元の情報で足りるか外部情報が必要かを確認する
次に、その作業に必要な情報がどこにあるかを見ます。
渡した資料の要約なら、その資料だけで進められます。
一方、最新情報の調査や社内データを使う仕事では、Web検索やデータベースなど、必要な情報へアクセスする仕組みが欠かせません。
LLMの能力だけでなく、回答の材料を用意できるかどうかも確認します。
誤りの影響が大きい作業ほど人間による確認を残す
最後に、出力が間違っていた場合の影響を考えます。
| 作業の性質 | 外部情報の必要性 | 誤りの影響 | 人間による確認 |
|---|---|---|---|
| 文章のたたき台 | 低い | 小さい | 軽い確認 |
| 最新情報の整理 | 高い | 中程度 | 出典を確認 |
| 契約・重要判断の補助 | 内容による | 大きい | 詳細な確認 |
あとから直しやすい文章の下書きなら、LLMへ任せる範囲を広げやすくなります。
金銭や契約などに関わる仕事では、LLMの出力だけで判断せず、人が確認する工程を残します。
LLMの能力を理解したら目的に合う活用方法を選ぶ
LLMは、すべて任せるか、まったく使わないかの二択ではありません。
文章生成や要約はLLMに任せ、最新情報の取得は検索機能を使い、最終判断は人が行う、と役割を分けることもできます。
「何を任せるか」「必要な情報はそろうか」「間違ったときの影響はどれくらいか」。
この3点を確認すれば、LLMを使う範囲を仕事ごとに決められます。
まとめ
LLMでできることは、文章生成だけではありません。
要約、翻訳、分類、情報抽出、質問応答、分析、コード生成など、言葉や情報を扱うさまざまな処理に使われています。
自分の仕事へ当てはめるときは、「メール作成に使えるか」「資料整理に使えるか」と用途だけで見るより、「生成する」「要約する」「取り出す」といった処理に分けて考えるほうが具体的です。
一方で、ChatGPTなどで使えるWeb検索やファイル処理のすべてが、LLM単体の能力というわけではありません。
LLMに検索や外部ツールを組み合わせることで、最新情報の取得やファイルの読み取りなど、対応できる作業が広がります。
そして、技術的に処理できることと、その結果をそのまま仕事で使ってよいことは別です。
任せる処理、必要な情報、誤りが起きたときの影響を分けて考えると、LLMに任せる部分と人が確認する部分を決められます。
仕事全体を任せられるかではなく、どの処理なら任せられるかを見ることが、LLMを実務で使うときの基準になります。
編集後記
私自身、LLMには記事を丸ごと任せるより、工程ごとに使うことが多いです。
文章のたたき台を作る、重複を探す、表現の癖を見直す、根拠を探す。
使うほど、「何ができるか」より「どこを任せるか」を考えるようになりました。
文章も情報も、最後に採用するかを決めるのは自分です。
LLMを使うことは、自分がどこを人の判断として残したいのかを知ることでもあると感じています。
よくある疑問
Q. LLMでは具体的に何ができますか?
文章生成だけでなく、要約、翻訳、分類、情報抽出、質問応答、分析、コード生成などに使えます。
「何に使うか」ではなく、「どんな処理を任せたいか」で見ると、自分の仕事にも当てはめやすくなります。
Q. LLMとChatGPTは同じものですか?
同じではありません。
LLMは、言葉や情報を生成・処理するモデルです。
ChatGPTは、そのLLMに検索やファイル処理などの機能を組み合わせたAIサービスです。
Q. LLMは最新情報をそのまま調べられますか?
LLM単体では、必要な最新情報を取得できるとは限りません。
最新の情報を扱うには、Web検索など外部情報へアクセスする仕組みが必要です。
Q. LLMの回答はどこまで信用できますか?
自然な文章でも、内容が正しいとは限りません。
日付、金額、固有名詞、出典などの事実情報や、仕事上の判断に影響する内容は、元の資料や一次情報で確認してから使います。
Q. 自分の仕事にLLMを使えるかはどう判断すればよいですか?
仕事を丸ごと考えるのではなく、文章生成、要約、情報抽出、分析などの処理に分けてみます。
そのうえで、必要な情報がそろっているか、間違った場合にどの程度の影響があるかを確認します。
この2点まで見ると、LLMに任せる部分と人が確認する部分を分けやすくなります。
参照・参考サイト
OpenAI・Building a data-driven, efficient culture with AI | Holiday Extras
https://openai.com/index/holiday-extras/
Microsoft Learn・RAG または Fine-Tuning を使用して LLM を拡張する
https://learn.microsoft.com/ja-jp/azure/developer/ai/augment-llm-rag-fine-tuning
OpenAI・言語モデルでハルシネーションがおきる理由
https://openai.com/ja-JP/index/why-language-models-hallucinate/
NIST・Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile
https://www.nist.gov/publications/artificial-intelligence-risk-management-framework-generative-artificial-intelligence
個人情報保護委員会・生成AIサービスの利用に関する注意喚起等について
https://www.ppc.go.jp/news/careful_information/230602_AI_utilize_alert/
文化庁・AIと著作権について
https://www.bunka.go.jp/seisaku/chosakuken/aiandcopyright.html


コメント